サンプルデータ(売上やアクセス数など)
「平均年収460万円」というニュースを目にするたび、自分の手取りや周囲の実情とのギャップに違和感を覚える人は少なくありません。学校のテストや身長の測定データのように、多くの統計は左右対称の「正規分布(ガウス分布)」を描くと教えられてきました。しかし、私たちが日々直面する年収や株価、Web記事のPV数といった現実のデータは、平均値を境に左右対称には並びません。
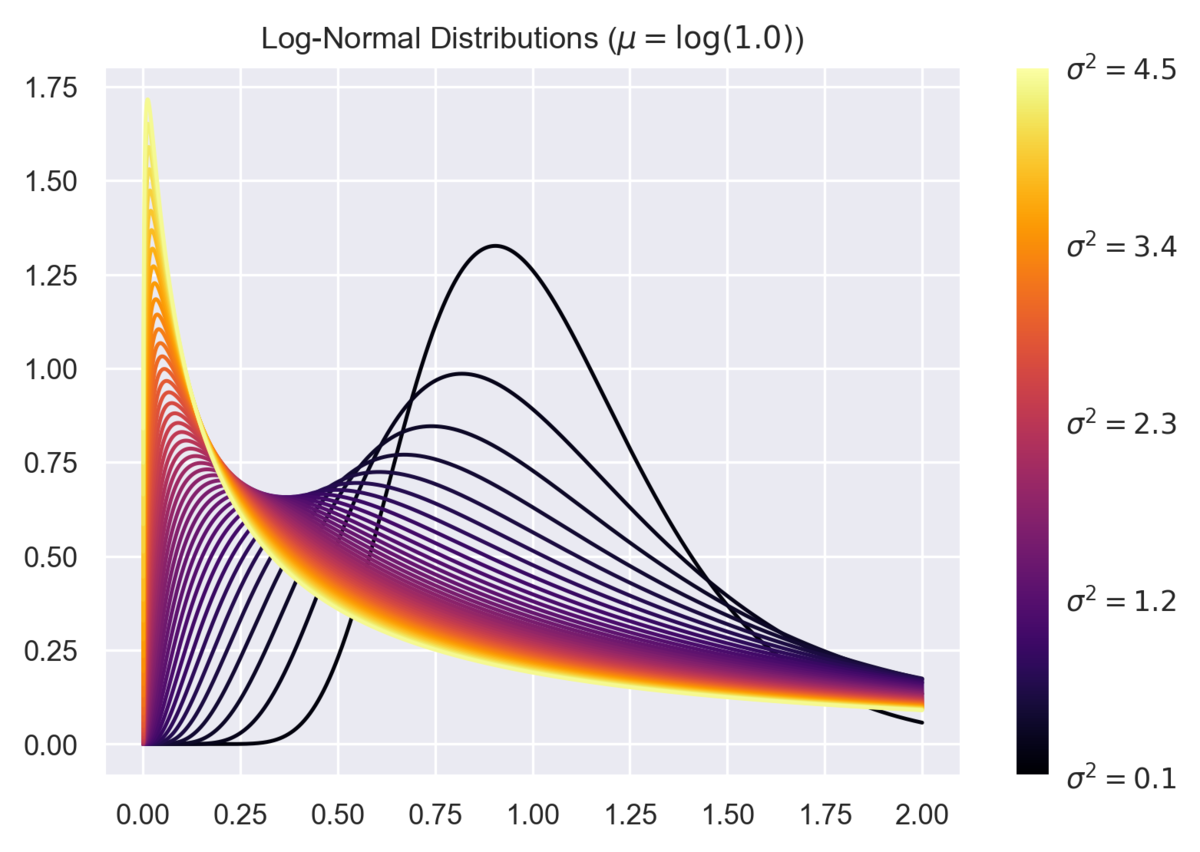
この強烈な違和感を解き明かす鍵こそが「対数正規分布」です。値がマイナスにならず、掛け算(比率)の積み重ねによって変化する事象では、データの山が左に寄り、右側へ細長く尾を引く独特の歪みが生じます。データサイエンスの重要性が一段と叫ばれる2026年現在、ビジネスの意思決定や投資判断で誤った判断を下さないために、この分布の仕組みと実践的な扱い方を押さえておきましょう。
📌 【この記事の重要ポイントまとめ】
- 要点1:年収や株価が正規分布にならないのは「下限がゼロ」「掛け算で増減する」という対数正規分布の特性が働くため。
- 要点2:対数正規分布では「平均値>中央値>最頻値」の順に数値がズレるため、平均値だけを見ると実態を見誤る。
- 要点3:Excel関数やPythonを活用すれば、誰でも簡単にパラメータ推定や確率計算を実務に応用できる。
【決定的な違い】年収や株価が「きれいな富士山型」にならない数学的理由
統計学の基本として誰もが知る正規分布は、平均値を中心に左右対称な富士山型の美しいカーブを描きます。これに対して対数正規分布と正規分布の違いは、端的に言えば「値そのものが足し算で変化するか、比率(掛け算)で変化するか」というメカニズムの差にあります。
例えば身長やテストの点数は、個人差や測定誤差が「足し引き」で積み重なるため、正規分布に収まりやすい性質を持ちます。一方で、対数正規分布株価変動理由を紐解くと、金融資産の価格は「前日比+5%」「翌週にマイナス3%」といった割合の掛け算によって推移します。さらに株価や年収には「マイナスが存在しない(ゼロが下限)」という絶対的な制約があります。下限がある状態で掛け算の連鎖が起きると、ごく一部の跳ね上がった数値が右側へ大きく引っ張られ、左右非対称な歪んだ分布が完成します。
これが社会統計における対数正規分布年収モデルの根本原理です。ごく少数の大富豪や高所得層が数億〜数十億円を稼ぎ出すことで右側の裾野が極端に伸び、大多数の一般労働者が集まる山は左側にぎゅっと圧縮されます。「平均年収より低い層が全体の約6割を占める」という日本の統計データは、まさにこの分布の形そのものを証明しています。
【平均値の罠】なぜ中央値と大きく乖離するのか?歪度と尖度で迫る正体
対数正規分布を理解するうえで最も警戒すべきなのが、対数正規分布平均値中央値の致命的な乖離です。左右対称の正規分布であれば「平均値=中央値=最頻値」が綺麗に一致しますが、対数正規分布では必ず「最頻値 < 中央値 < 平均値」という不等式が成り立ちます。
分布の非対称性を示す指標が対数正規分布歪度と尖度です。歪度(わいど)は山の非対称度、尖度(せんど)は頂点の尖り具合と裾野の重さを表します。対数正規分布は常に正の歪度(右に裾が長い)を持ち、分散が大きくなるほど裾野が極端に重いヘビーテイルを形成します。外れ値のように見える極端な高所得層や爆発的な株価高騰が、全体の平均値を強引に引き上げてしまうのです。
マーケティングの現場や給与体系の分析で平均値だけを追っていると、ボリュームゾーン(最頻値)の顧客や社員の実態から大きくピントが外れてしまいます。「実感に近い数字」を把握したい局面では、中央値(ちょうど順位が真ん中の人の値)や最頻値(最も人数が多い階層)をセットで確認する姿勢が不可欠です。
【数式を紐解く】対数正規分布の確率密度関数と分散の公式
データ分析の専門知識を深めるために、数学的な骨組みも整理しておきましょう。確率変数 $X$ の自然対数 $\ln(X)$ が平均 $\mu$、分散 $\sigma^2$ の正規分布に従うとき、$X$ は対数正規分布に従うと定義されます。
このときの対数正規分布確率密度関数 $f(x)$ は、以下の数式で表されます(ただし $x > 0$)。
$$f(x) = \frac{1}{x \sigma \sqrt{2\pi}} \exp\left( -\frac{(\ln x - \mu)^2}{2\sigma^2} \right)$$
分母に独立した $x$ が入っている点が、通常の正規分布とは決定的に異なります。この数式から導き出される期待値(平均値)と対数正規分布分散公式は次の通りです。
・期待値(平均値):$$E[X] = \exp\left(\mu + \frac{\sigma^2}{2}\right)$$
・分散:$$V[X] = \exp(2\mu + \sigma^2)\left(\exp(\sigma^2) - 1\right)$$
数式を見ても分かる通り、対数変換後のパラメータ $\mu$ や $\sigma^2$ がそのまま元のデータの平均や分散になるわけではありません。対数空間の分散 $\sigma^2$ が大きくなればなるほど、指数関数的に期待値や分散が爆発する構造を秘めています。
【実務で使える】パラメータ推定と最尤推定、Pythonでの実装テクニック
手元の実データを対数正規分布モデルに当てはめる場合、まずは観測値から母数を割り出す対数正規分布パラメータ推定が必要です。最も標準的で強力なアプローチが対数正規分布最尤推定(Maximum Likelihood Estimation: MLE)です。
対数正規分布の最尤推定は、実はシンプルです。手元のデータ $x_1, x_2, \dots, x_n$ の自然対数をすべて取り、$y_i = \ln(x_i)$ という対数変換データを生成します。この $y_i$ に対して通常の正規分布の平均と分散を計算するだけで、理論上の最尤推定量が求まります。
近年のデータ分析現場で欠かせない対数正規分布Python実装も、scipy.stats ライブラリを使えばわずか数行で完結します。
import numpy as np
 from scipy.stats import lognorm

 data = np.array([12, 18, 25, 45, 80, 150, 320, 950])

 # 最尤推定によるパラメータフィッティング
 shape, loc, scale = lognorm.fit(data, floc=0)
 # shapeがσ、np.log(scale)がμに相当
 print(f"推定量 μ: {np.log(scale):.4f}, σ: {shape:.4f}")
このようにプログラミングを用いれば、複雑な確率モデルの当てはめも即座に実行できます。
【現場の時短技】エクセル(Excel)で対数正規分布を瞬時に計算する手順
「Pythonなどのコードを書かずに、手軽にスプレッドシート上でリスク試算や確率を求めたい」というビジネスパーソンも多いはずです。オフィスソフトを活用した対数正規分布エクセル計算は、専用の組み込み関数を使うことで驚くほどスムーズに行えます。
Excelには対数正規分布を扱うための関数が主に2つ用意されています。
1. LOGNORM.DIST(累積確率や確率密度を求める)
構文:=LOGNORM.DIST(x, 平均, 標準偏差, 関数形式)
・「x」:計算したい閾値(例:年収800万円など)
・「平均」:データを対数化した後の平均値($\mu$)
・「標準偏差」:データを対数化した後の標準偏差($\sigma$)
・「関数形式」:累積分布関数を求めるなら「TRUE」、確率密度関数なら「FALSE」
例として「年収が800万円以下になる確率」を求める際は、累積オプションにTRUEを指定します。
2. LOGNORM.INV(確率から逆算して数値を割り出す)
構文:=LOGNORM.INV(確率, 平均, 標準偏差)
金融リスク管理の「VaR(バリュー・アット・リスク)」のように、「95%の確率で収まる損失限度額はいくらか」といった逆引き計算を行う際に威力を発揮します。
社内プレゼン資料や事業計画書を作成する際、これらの関数を使いこなせれば、単なる平均値比較を超えた説得力のある分析シナリオを構築できます。
【実社会での応用】金融・医療・ネット通販に見る対数正規分布の実用例
対数正規分布は、机上の空論ではなく私たちの身の回りのあらゆる現象を支配しています。ここで一度、対数正規分布実用例まとめとして代表的なフィールドを俯瞰してみましょう。
① 金融工学とオプション価格決定
ノーベル経済学賞を受賞した「ブラック・ショールズ方程式」は、株価の将来値が対数正規分布に従うという仮定の上に成り立っています。投資の世界でリスク(ボラティリティ)を測る土台そのものです。
② デジタルマーケティングとECサイトの行動ログ
オウンドメディアの滞在時間や、ECサイトでのユーザー別年間購入金額も顕著な対数正規分布を示します。大半のユーザーは短時間で離脱し少額決済ですが、ごく一部のファン層・ロイヤルカスタマーが滞在時間や売上を強力に牽引します。
③ 医療・感染症疫学と生物学
ウイルスの感染から発症までの「潜伏期間」、薬の血中濃度が半減するまでの時間、さらには細胞のサイズ分布など、生命現象の多くにも対数正規分布が現れます。
④ 製造業における信頼性工学
半導体デバイスや自動車部品の摩耗・金属疲労による「故障寿命」の予測にも頻繁に用いられます。突然壊れる初期不良を過ぎた後、徐々に壊れていく寿命のばらつきを捉えるのに最適なモデルです。
【対数正規分布】に関するよくある質問(FAQ)
Q1:データが正規分布か対数正規分布かを見分ける手軽な方法はありますか?
A1:最も手軽なのは、生データのヒストグラムを作成してみることです。右側に長い裾野があり値が正(プラス)のみなら、対数変換(自然対数を取る)を行ってみてください。変換後のヒストグラムが左右対称の釣り鐘型に近づけば、対数正規分布である可能性が極めて高いと判断できます。統計ソフトではQQプロット(正規確率プロット)を描くのが確実です。
Q2:負の値(マイナス)を含むデータに対数正規分布は使えませんか?
A2:そのままでは使用できません。自然対数 $\ln(x)$ は定義域が $x > 0$ に限られるためです。マイナスの利益や温度(摂氏)など負の値を取り得るデータセットには、一般化極値分布など別の確率分布を採用するか、最小値を下回らないように定数を加算してシフトさせる「3母数対数正規分布」を検討します。
Q3:なぜビジネスの現場では正規分布ばかりが多用されてしまうのですか?
A3:中心極限定理の存在と計算の容易さによる「思い込み」が主な理由です。サンプル数が多ければ何でも正規分布に近づくという誤解が根強く残っています。しかし、個々の値が掛け算のプロセスで決まる指標に対して正規分布を無理に当てはめると、リスクの過小評価や事業計画の大幅なブレを招く原因になります。
まとめ:歪んだ現実を正しく見抜くリテラシーを
私たちは無意識のうちに「平均が標準であり、大半の人がその付近にいる」という均質的な世界観を前提にしがちです。しかし、資本主義社会の経済データや自然界の多くの営みは、本質的に右に歪んだ対数正規分布の世界に生きています。
「平均値の罠」に惑わされず、背後にあるメカニズムが足し算なのか掛け算なのかを見極める眼差しを持つこと。それだけで、飛び交う統計ニュースの真意や投資市場のリスク、事業データの解像度は劇的に変わります。手元のデータを分析する際は、ぜひ対数正規分布の視点を取り入れ、数字の裏に隠された真実を鋭く捉えてみてください。 (出典: 対数 正規 分布(Yahoo!ニュース))


毎日更新されるトレンド情報を分析・発信中。役立つ裏技やおすすめ情報を分かりやすく紹介します。
